ttEncrypt VMP反编译插件
某音35.2.0,简单记录结合AI对抖音自定义VMP进行编写VMP插件进行可视化还原的过程
1.逆向VMP结构
这部分是去年年底完成的,所以分析大部分是手动完成的,如今看来,AI应该只需要一个小时就可以完整还原整个VMP结构以及handle对应指令
post请求密文/ttEncrypt
可以hook 控制com.ss.android.common.applog.sendEncryptLog的方法
1.确定这个方法对post请求进行了加密
加密方式是gzip+EncryptorUtil.ttEncrypt
2.逆向这个ttEncrypt方法
package com.bytedance.frameworks.encryptor; |
var EncryptorUtil = Java.use("com.bytedance.frameworks.encryptor.EncryptorUtil"); |
hook,不过这里hook的时候是有frida检测的应该,这里我没有选择去找frida检测,可以直接正常启动,然后再把这个hook代码注释给取消掉,就可以正常hook到内容,,
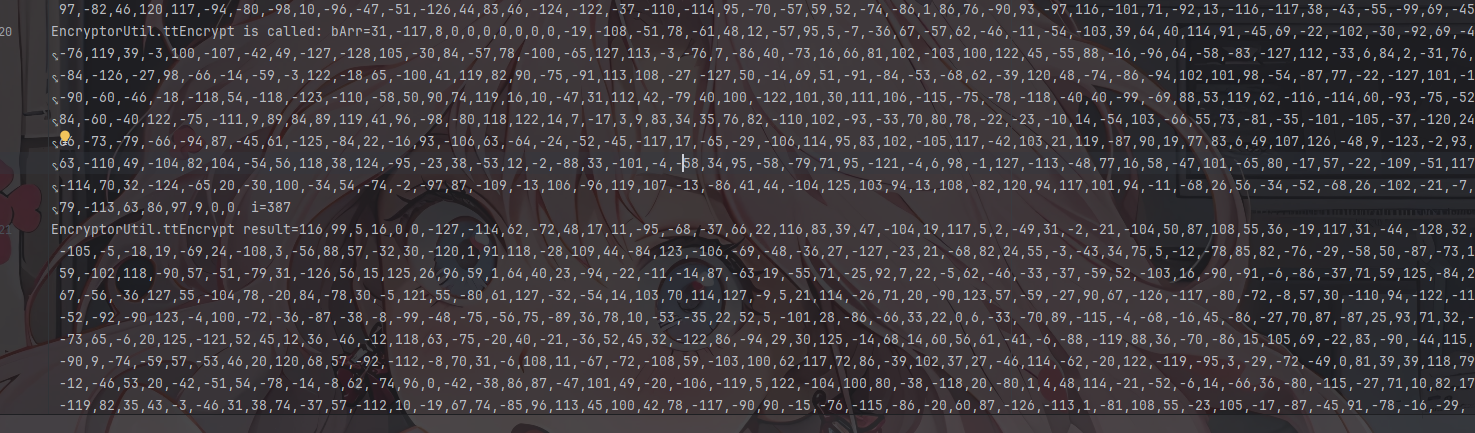
接下来就可以分析so里面的内容然后进行同构了
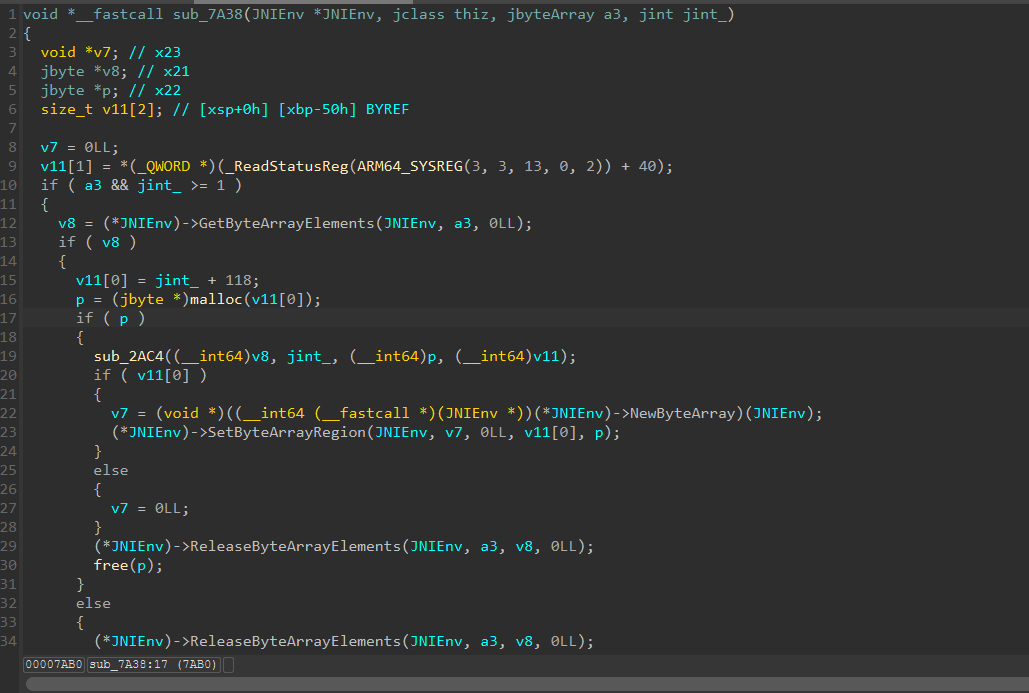
可以看到这里是传入了数组和数组大小,返回大小应该是原本数大小+118
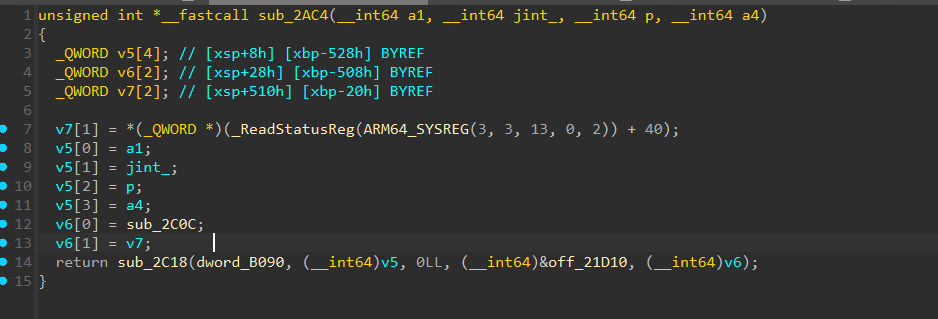
这里又把我们的输入绑定到一个数组,或者说结构体,然后传入这个vm虚拟化的函数
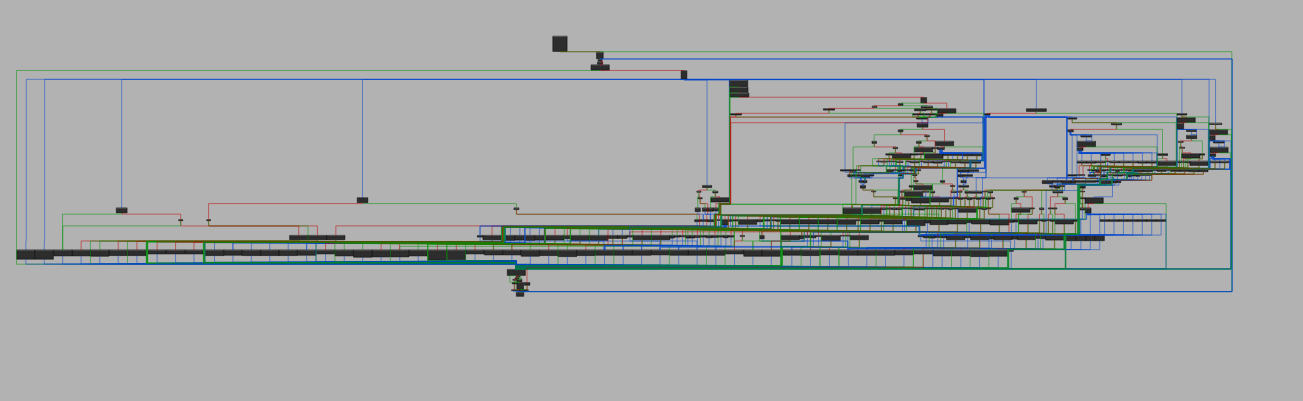
简直无从下手
unidbg trace
package Douyin_ttEncrypt; |
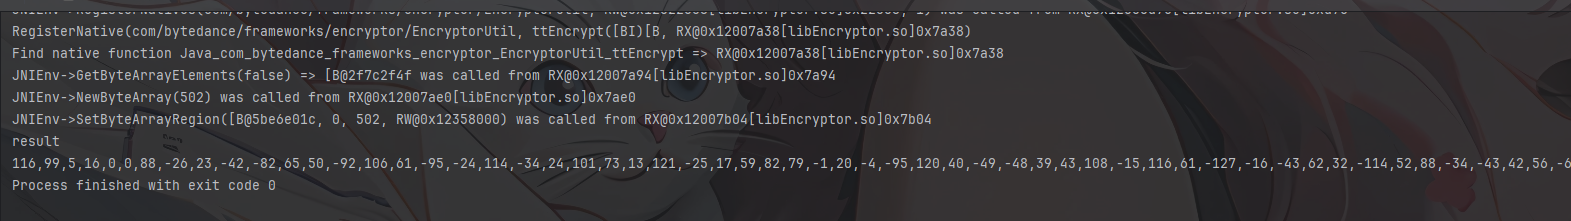
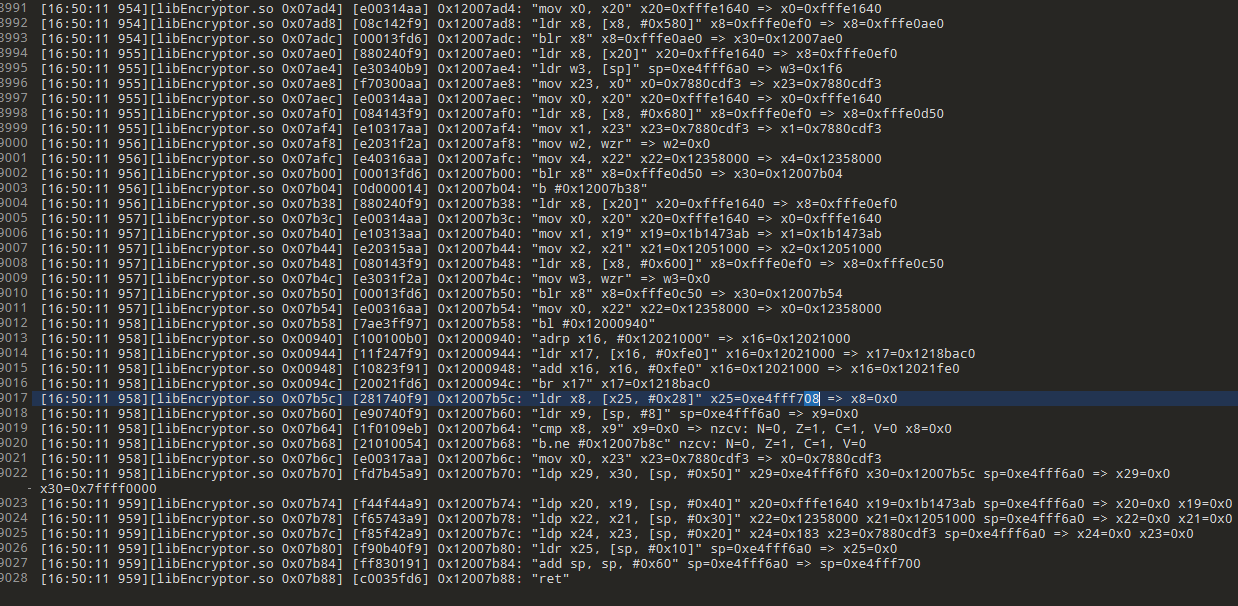
成功trace出,接下来就是慢慢分析然后同构代码
先结合trace文件逆向一下每一个的分发块,handle试试
这个反编译代码给我的第一感觉就是这个不只有一个分发块??
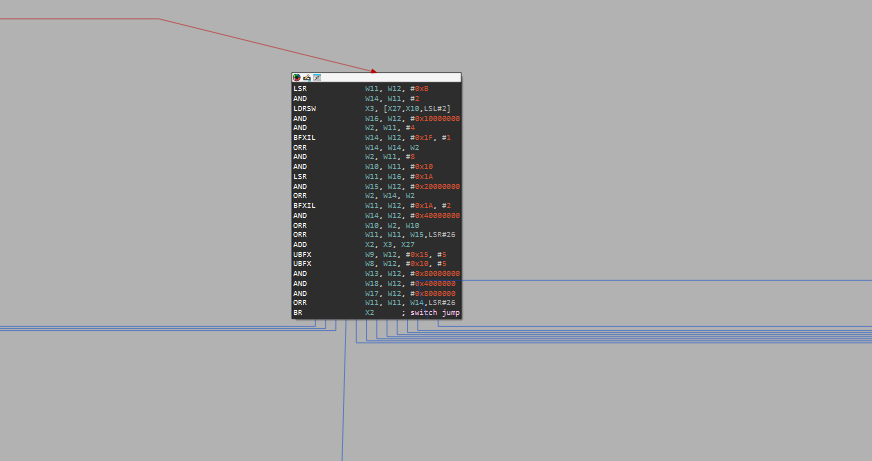
通过cfg可以暂时确定主要分发块是这个
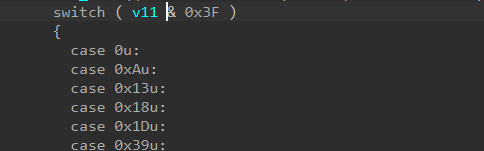
vmp handle
第一次逆vmp,一步一步来吧
回到sub_2AC4这个函数
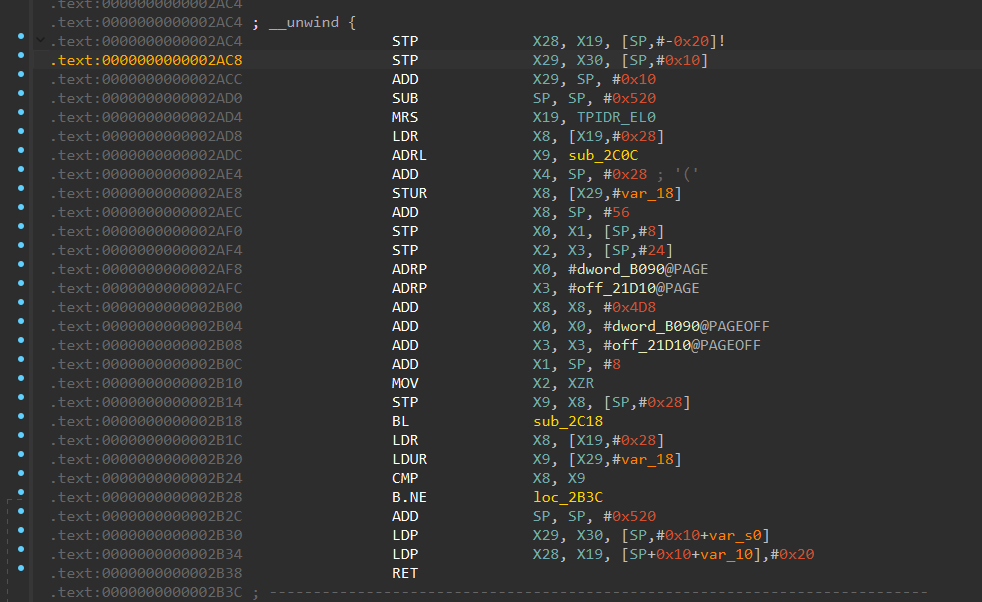
注意到这里调用函数的时候传了5个参数,第五个参数是一个地址,是SP, #0x28
而这里很小的函数却开辟了0x520的栈空间,可以推测出后面的虚拟机函数会用到这个栈
分发器这个过程还需要挨个去读汇编,确定哪些位是干什么的
W11[2] : W12[28] .TEXT:0000000000002D04 W11,W16,#0X1A ;W11 ; W16 >> 0X1A,即右移26 LSR W15,W12,#0X2000000 ;W15 保留 W12第 30 位 .TEXT:0000000000002D08 AND W2,W14,W2; 或运算后,W2取 W12 第 13,14,15,32位 TEXT:0000000000002D0C ORR --> W11[0-1] 三 W12[26:27] TEXT:0000000000002D10 W11取W12第27,28位 W11, W12, #0X1A, #2 BFXIL W14保留W12第31位 TEXT:0000000000002D14 W14, W12, #0X4000000 AND 取 W12第13,14,15,16,32位 TEXT:0000000000002D18 ORR W10,W2,W10 ; W10取 TEXT:0000000000002D1C W11, W11, W15,LSR#26 J W11 - ORR 1]] (W15 >> 26) ---> W11[3] - W12[29] TEXT:00000000000002D20 X2,X3,X27 ; X2指向实际的跳转地址 ADD W9, W12, #0X15, #5 ; W9 - W12[21:25] .TEXT:0000000000002D24 UBFX UBFX W8 W12[16:20] .TEXT:000000000002D28 W8,W12,#0X10,#5 ; ; JUMPTABLE 0000000000002E94 CASE 58 W16 :W12 &0X800000 低31位清0,保留第3! TEXT:0000000000002D2C W13,W12,#0X80000000 AND W18-W12&0X40000000 低26位清0,保留第27位 W18[26] W12[26] W18,W12,#0X4000000 TEXT:0000000000002D30 AND 低27位清0,保留第28位 W17[27]: W12[27] .TEXT:0000000000002D34 AND W17,W12,#0X800000 W17 W12&0X 0X8000000 .TEXT:0000000000002D38 W14 >> 26) W11, W11, W14,LSR#26 -> W11[4] 三 W12[30] ORR WI1 : W11 ( X2 J SWITCH JUMP BR .TEXT:0000000000002D3C .TEXT:000000000002D40 TEXT:0000000000002D40 -->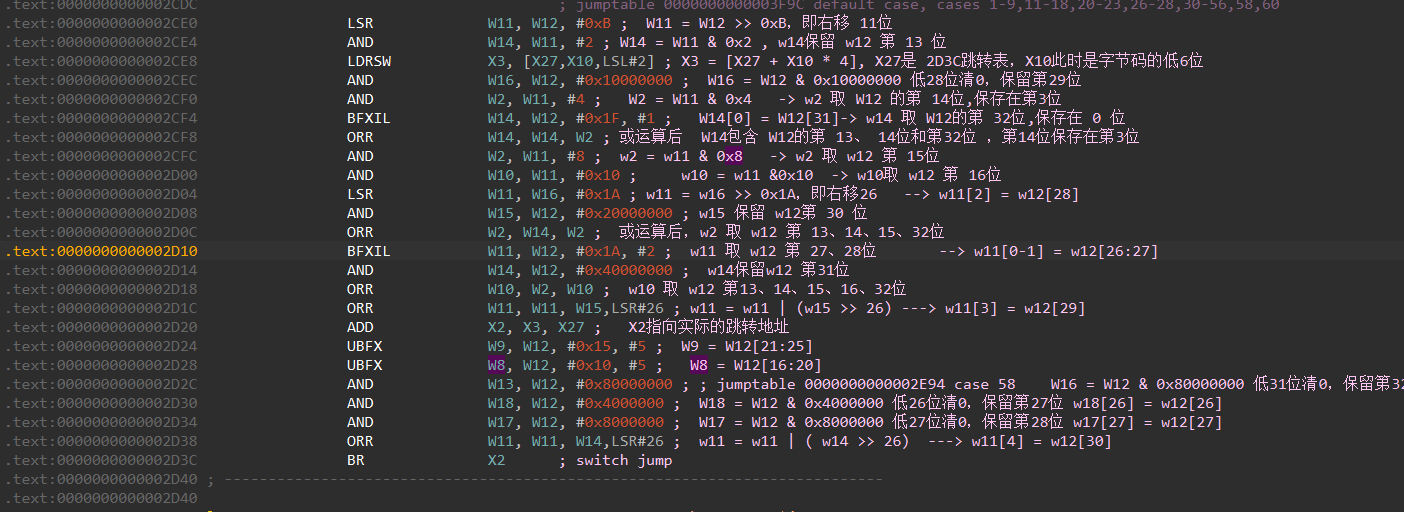
这里的分析过程需要结合前面的函数传参
最终的总结结果是,从x0取出了4字节保存w12中,x0就是前面的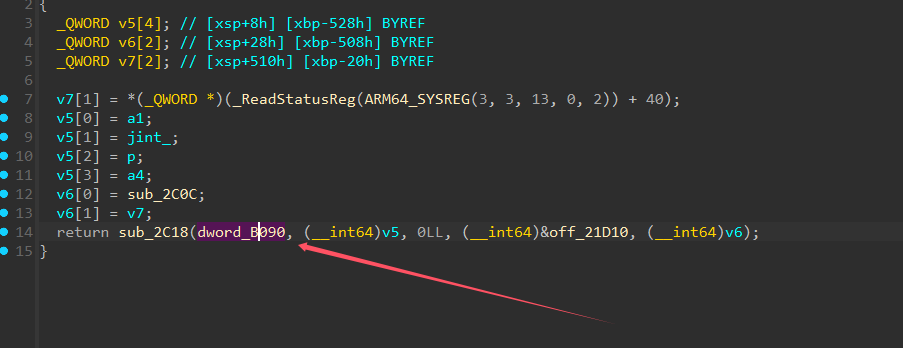
之后w12[0-6]低6位就是取出的地址索引,取出地址索引定位出跳转地址,w8=x12[16:20],w19=w12[21-25]
w10=w12[31,12:15] w11=w12[26:30]
结合trace的内容去分析有多少个
#!/usr/bin/env python3 |
先随便尝试一个低6位的值拿去寻找跳转的哪个地址,拿出23
打印一下调用顺序
opcode 0x15 |
opcode 0x17 STR Xn , [Xd + imm]
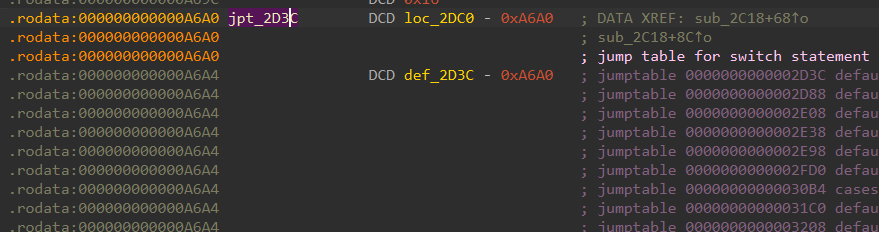
这个是起始地址
结果是0xa6a0+23*4=A6FC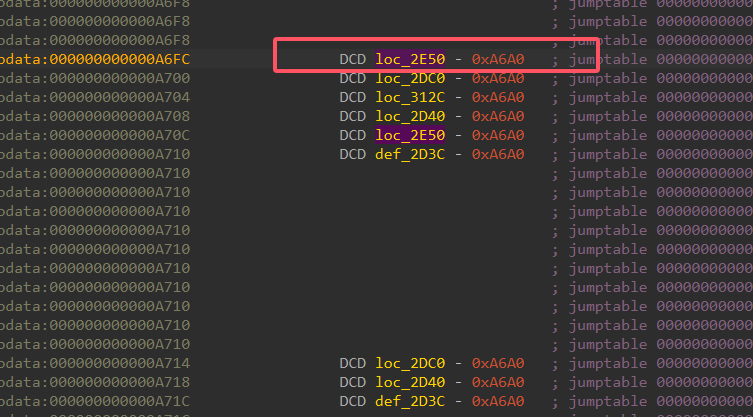
text:0000000000002E50 loc_2E50 ; CODE XREF: sub_2C18+124↑j |
这里就是按照w10的值去重新计算opcode再取值,我们再取一次
x10=(w12&0x3f) -0x14
x10=[x23+(x10*4)]
就是0x8014+4*3
跳转到0x8020就是
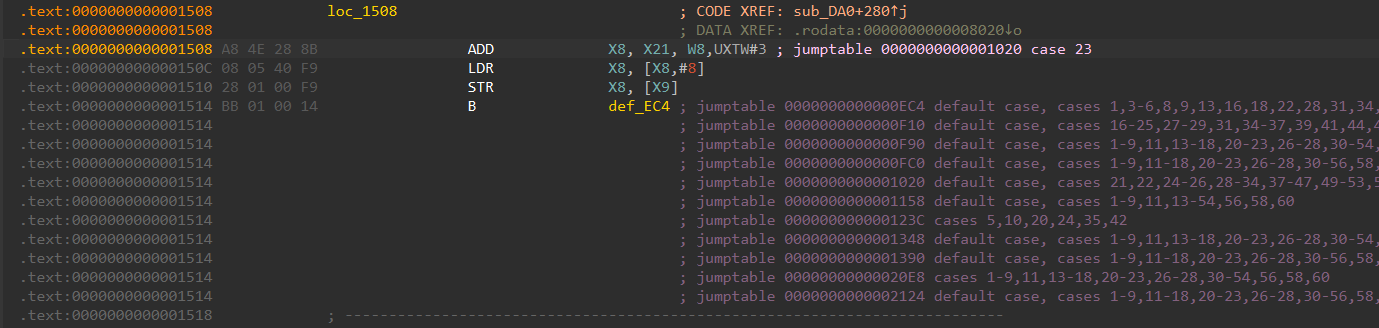
W8 = W12[16:20],至于这里的x21的值挺困惑的,有点像上下文啥的
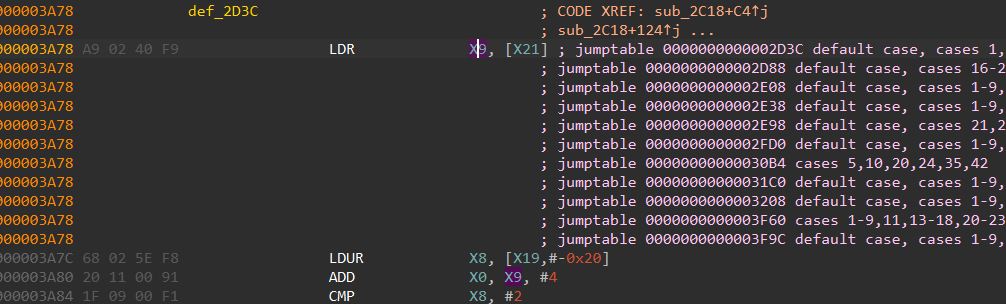
看到这个发现,x21应该是vm的上下文环境,第一个字段就是pc
X21 +0x00 : uint64 pc; // 当前字节码指针 |
这里的x9是x21+(uint64)(W12[21:25])*8
W12[21:25]是取出虚拟寄存器的索引
然后
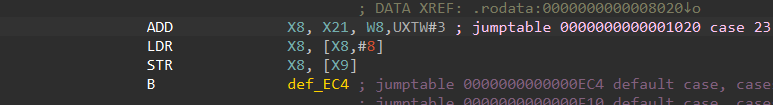
ADD X9, X21, W9,UXTW#3 ; x9=x21+(uint64)w9*8 |
就是得到虚拟寄存器的真实地址
然后取出寄存器加上一个常数应该
ADD X9, X9, W11,SXTH ; X9 = X9 + sign_extend_16(W11) |
X9 = vXn + imm
所以这个指令就比较明显了
str
就是**STR Xn , [Xd + imm]**
为此我们还可以推断出W12[16:20]是源寄存器索引,W12[21:25] 是目标寄存器索引,其他的就是常数
opcode 0x15 ADD Xd,Xn,#imme

opcode 0x15是trace里面的第一个虚拟机指令
0xa6a0+0x15*4=00A6F4
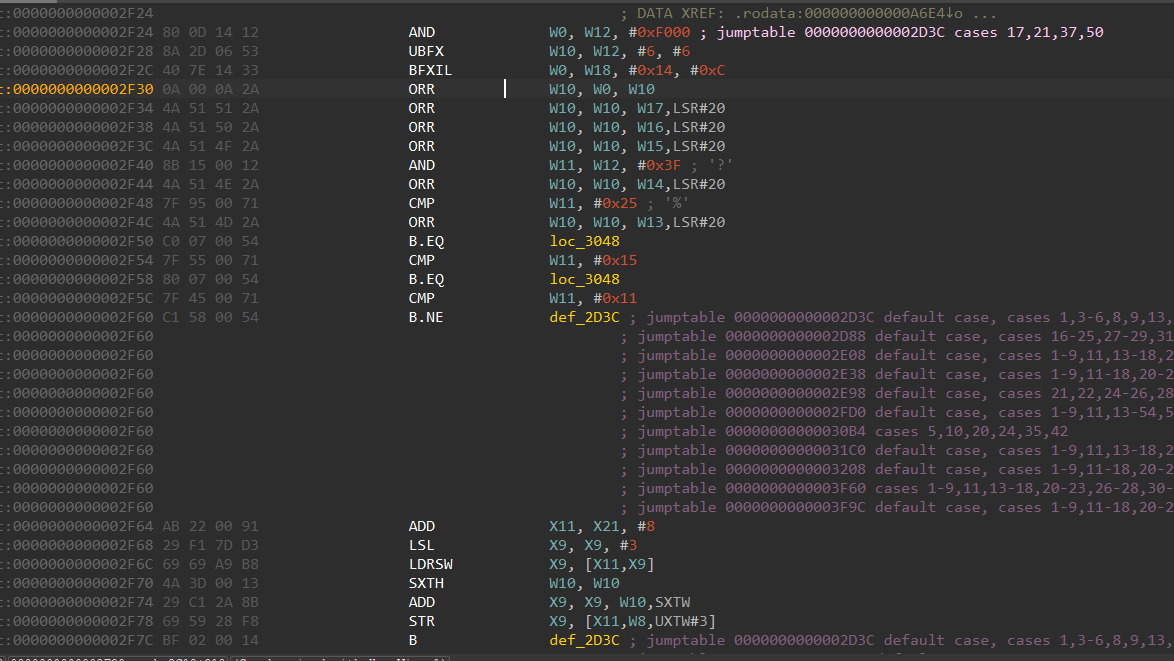
前面似乎都是在解析常量,后面这里
.text:cc AB 22 00 91 ADD X11, X21, #8 ; 取出虚拟机环境指针 |
这里的w8就是目标寄存器,x9就是源寄存器
ADD Xd,Xn,#imme
opcode 0x28 LOAD Xd, [Xn, #imme]
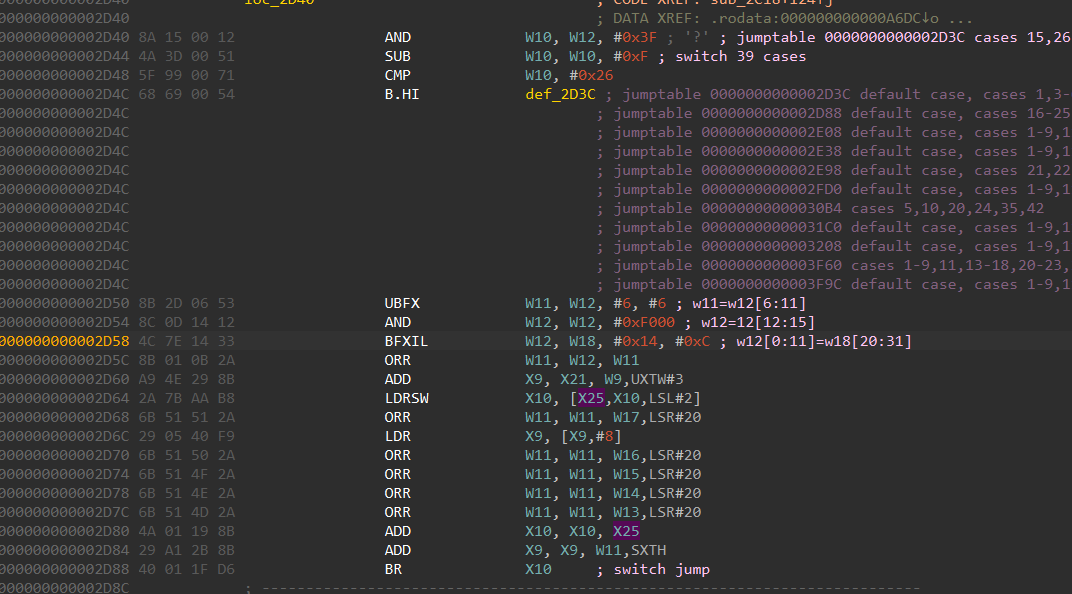
这里就是取出虚拟寄存器的值,得到x9,然后这里是加上了一个常数
这里继续跳转
text:0000000000003318 29 01 40 F9 LDR X9, [X9] ; jumptable 0000000000002D88 case 40 |
然后再取出一个值
text:0000000000003A70 A8 4E 28 8B ADD X8, X21, W8,UXTW#3 |
从虚拟寄存器中取出,然后把前面取出的值加上常数后再取的值放进虚拟寄存器中
这里就是从内存中加载一个值放进了寄存器之中
所以这里的指令就是 LOAD Xd, [Xn, #imme]
这里的w9的源寄存器索引,w8是目的寄存器索引
opcode 0xb 0x7 ORR Xd, Xn, Xt
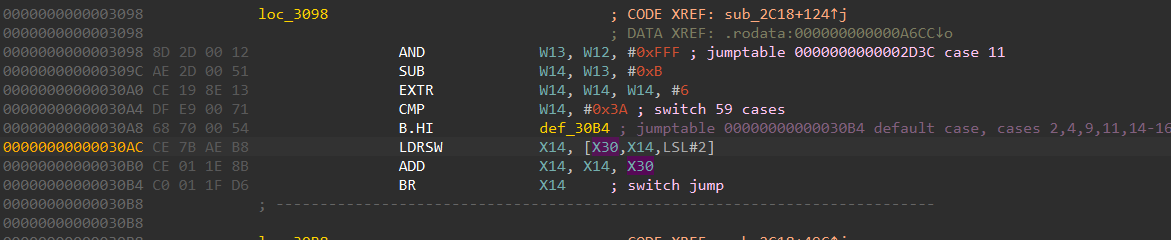
当opcode 等于0xb的时候,有多个可能的跳转结果,因为是基于w12与运算0xfff之后的结果
这里可以计算一下有几种结果
f = open("D:\\Android\\DOUYIN\\DOUyin\\lib\\arm64-v8a\\libEncryptor.so", "rb") |
有多种结果,一种一种分析就行
opcode1-> 0x15 |
00000000038F8 8B 2D 00 12 AND W11, W12, #0xFFF ; jumptable 00000000000030B4 cases 3,7,30,46 |
这个指令很明显是orr 或运算的指令ORR Xd, Xn, Xt
opcode 0xb 0x27 cmp xn ,xt ; set xd,LT
.text:0000000000003F18 loc_3F18 ; CODE XREF: sub_2C18+49C↑j |
这里相当于 cmp xn ,xt ; set xd,LT 如果小于,就设置目标寄存器为1,否则设置为0
opcode 0xb 0x19 LSL Xd, Xn , #imme
这里根据trace的来分析好了
12003888: "cmp w13, #0xd0a" => nzcv: N=1, Z=0, C=0, V=0 w13=0x64b |
看trace比较明显,这里的w11是一次opcode和二次opcode中间的一个计算出常数的过程
先加载一个寄存器出来,然后lsl 一定的位数,最后再放到另外一个寄存器里面去。
这里的指令就是LSL Xd, Xn , #imme
opcode 0xb 0xc add xd,xn,xt
030b8: "and w11, w12, #0xfff" w12=0xc1230b => w11=0x30b |
加法?,但是看反编译似乎是根据多种比较结果进行不同的运算,有乘和减法?
先暂时就看他是加法吧
Xd = Xn + Xt
opcode 0xb 0x2b blr xn
16:50:10 573][libEncryptor.so 0x03f38] [01daffb5] 0x12003f38: "cbnz x1, #0x12003a78" x1=0x0 |
设置[X19,#-0x18] 为某个虚拟寄存器的值,设置 [X19,#-0x20] 的值为 2
注意到vmp的公共末尾处,当[X19 - 0x20] 的值为 1 或 3 时
|
这里是设置[X19,#-0x20]为0了,然后判断这个虚拟寄存器的值是不是0,然后跳转,注意这里的loc_2CC4是取指令的开头了
当 [X19,#-0x20] 等于 2 时
.text:0000000000003AA8 loc_3AA8 ; CODE XREF: sub_2C18+E74↑j |
所以这里就是跳转指令和函数调用指令这种涉及到修改pc的操作
当[X19,#-0x20] 等于 2 的时候,会在执行下一条指令之后,再末尾执行修改pc的操作,延迟修改
函数调用的时候。[X19,#-0x18] 是被设置成跳板函数地址,函数执行完之后,会从[X19,#-0x10] 恢复虚拟PC
所以这个是blr xn ,跳转去寄存器,然后把返回地址放入 lr(x30)中
函数调用
x20是跳板函数的地址
.text:0000000000002C0C ; __int64 __fastcall sub_2C0C(__int64 (__fastcall *)(__int64), __int64) |
opcode 0x18 cmp xn,xm
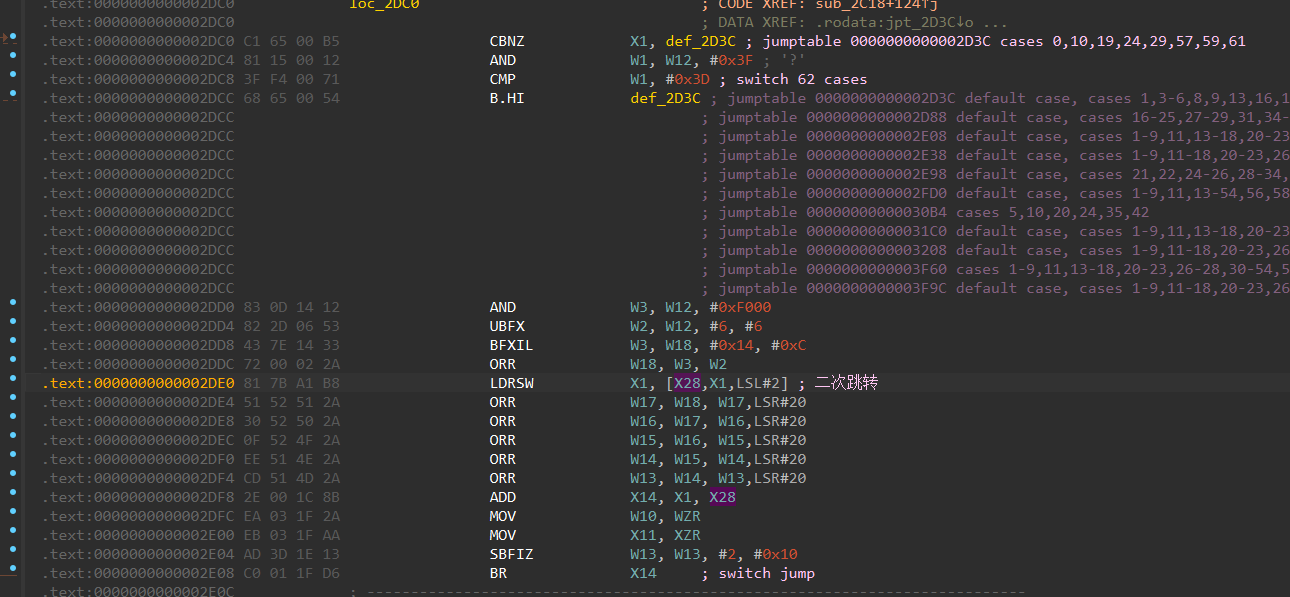
有个固定的二次跳转
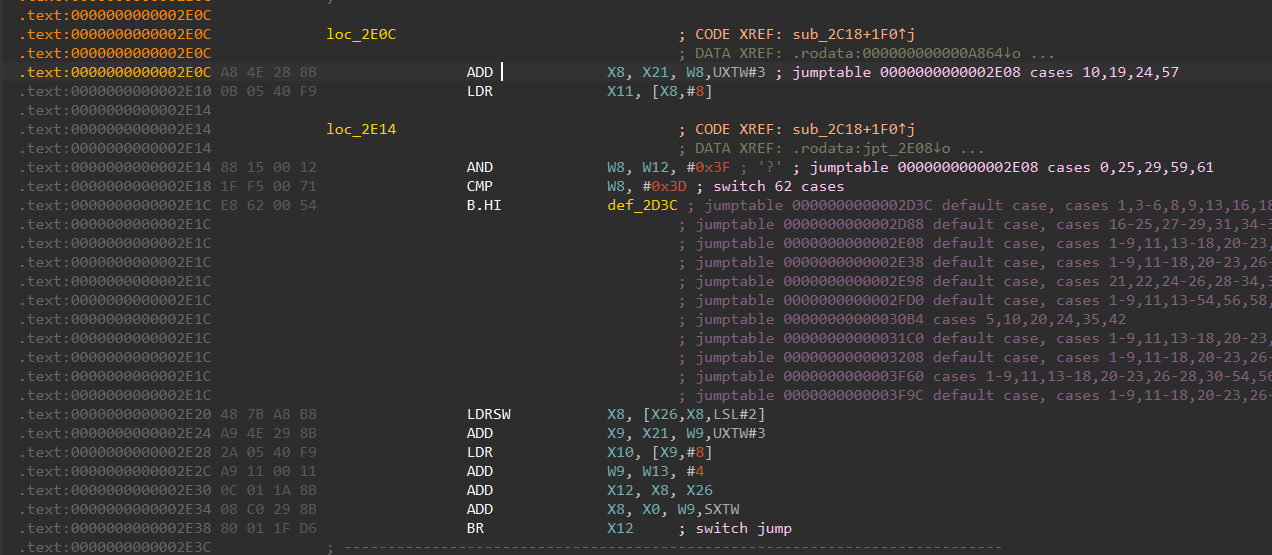
.text:00000000000034A4 loc_34A4 ; CODE XREF: sub_2C18+220↑j |
综合分析下来
发现这个很可能是cmp xn,xm的指令,比较后还设置了相关虚拟寄存器的值以及控制变量的值,保存了pc指针(当前指令后两个指令pc到[X19,#-0x18])的值
大致就是,当[X19,#-0x20] = 1的时候,指令末尾就进行跳转指令,如果等于2 的话,会再下一条指令结束的时候执行跳转操作,所以这是条件跳转指令
当xm!=xn的时候,直接跳转到PC+8的位置,当xm ==xn的时候,跳转到PC+ #imme
opcode 0x34 nop?
[16:50:10 529][libEncryptor.so 0x02ecc] [800d1412] 0x12002ecc: "and w0, w12, #0xf000" w12=0xf001f8b4 => w0=0xf000 |
opcode 0x30 STORE Xn, [Xd + #imme]
[16:50:11 553][libEncryptor.so 0x02e50] [8a150012] 0x12002e50: "and w10, w12, #0x3f" w12=0xfa10c30 => w10=0x30 |
STORE Xn, [Xd + #imme]
opcode 0xc b labe
[16:50:11 927][libEncryptor.so 0x02f80] [c15700b5] 0x12002f80: "cbnz x1, #0x12003a78" x1=0x0 |
vmp编码的起始地址加上一个常数存到[x19,#- 0x18], [x19,#- 0x20]设置为2,实现指令 b labe
opcode 0x7 or xd, xn, #imm
[16:50:10 533][libEncryptor.so 0x02ecc] [800d1412] 0x12002ecc: "and w0, w12, #0xf000" w12=0x84215c07 => w0=0x5000 |
总分析
前函数开辟了很大的栈空间,是为了给vm函数提供空间,这个空间的首地址是被存储在了x19中
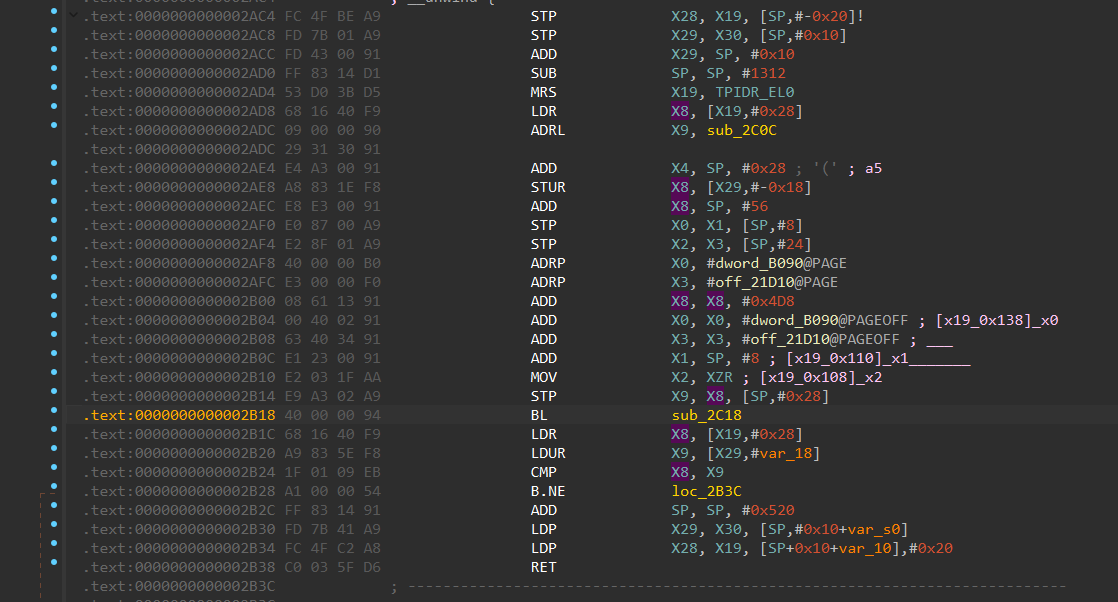
ext:0000000000002C34 94 4C 40 A9 LDP X20, X19, [X4] ; 将0x2c0c地址和一个虚拟地址存入x20,x19 |
后面会涉及到对虚拟内存指针的赋值操作
我们在分析handle的时候就注意到,虚拟寄存器的索引是通过x21来找的,x21是在x21=x19-0x138的位置
所以,x21=x19-0x138是PC指针,x19-0x130就是虚拟寄存器x0,依次类推
并且在我们进行函数调用的时候
X19 - 0x20 表示控制变量,控制流程和函数调用
X19 - 0x18 用于配合控制变量保存地址
X19 - 0x10 表示函数的返回地址
X19 - 0x8 表示初始的 PC地址,即 opcode 首地址
真实函数参数指针保存在 [X19 - 0x110],即虚拟寄存器 X4。
参数 3 保存在 [X19 - 0x108],即虚拟寄存器 X5 = 0。
参数4 ,函数地址, 保存在 [X19-0x100],即虚拟寄存器 X6。
跳板函数sub_2D1C保存在 [X19- 0xF8],即虚拟寄存器 X7。
2.编写VMP插件
如果还原出了vmp的handle对应指令,又知道函数入参约定的话,按照平常CTF的VM经验,我们的做法是写一个简单的vm还原脚本,这种脚本只能还原到汇编层面,有的脚本甚至是打印输入的数据流
这里贴一个以前网上找的并且自己修改一些的简单还原脚本
import struct |
还原出来的格式是
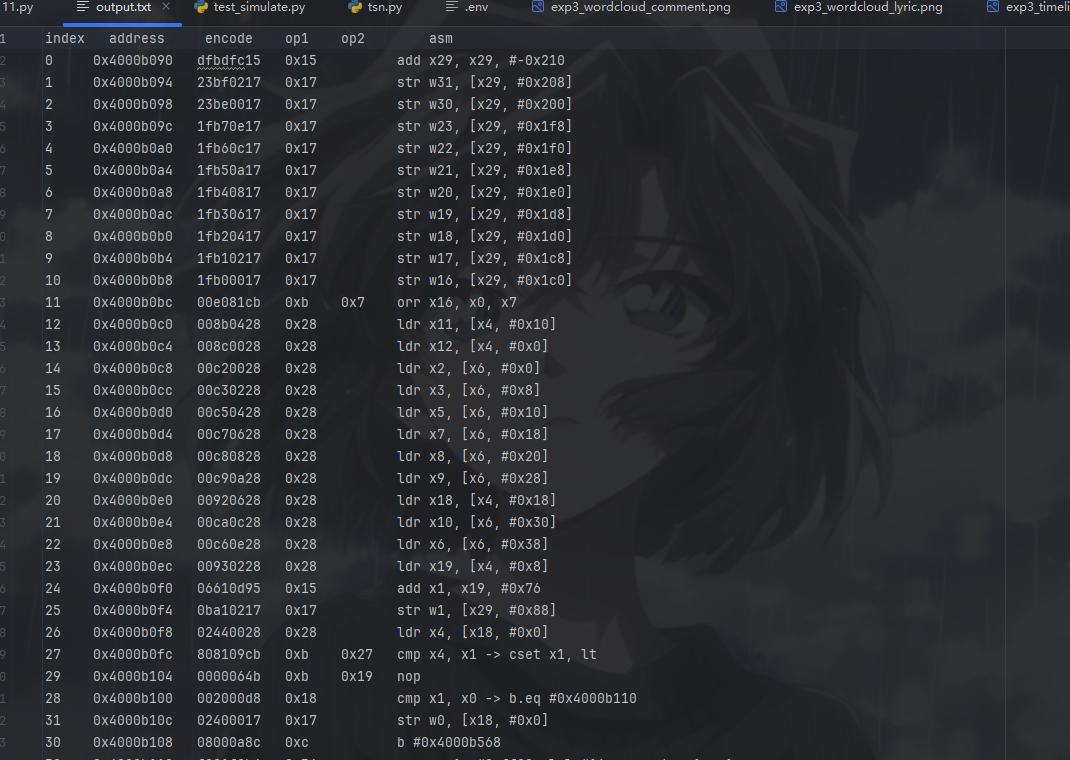
可以看到只能看到汇编的,而且这种程度也不够,我们的思路是写一个反编译插件,达到lifter到伪代码的效果,据说可以选择LLVM或者bn的插件,这里选择的插件方式
这一part的代码就基本上是AI写的了,给他反编译的思路,如今AI能在3-4天内写出一个反编译插件确实让我感到震惊。
逆向VMP的时候,感觉分析VMP是一件费事费力的操作,就算我们拿到一份trace文件,在经过VMP保护后的程序分析起来也是极其的不便,动不动就几百万行,已经不是人能看的了,现在如果是分析纯算法,在agent的帮助下,在写几个分析VMP的skill,分析其算法可以上一层楼,笔者在使用ida mcp结合trace文件,再结合agent去分析VMP的时候,AI分析handle的能力确实令人叹为观止,大概能很好的分析出70%的VMP handle了,但是VMP还原是一个痛点,我分析某音的ttencrypt的时候是硬还原,也就是直接打印出虚拟指令,但是某音的VMP似乎有非常多VM函数,分析也是困难,干脆直接写一个架构,读着方便,而且还能反编译成伪c
Binary Ninja 架构插件怎么写
1. 架构插件
Binary Ninja 的核心思路不是“只支持固定几种 CPU”,而是把“架构”和“分析”分层:前者负责把字节翻译成指令语义,后者基于这些语义继续做 CFG、数据流、MLIL、HLIL 和反编译。所以当你面对一种自定义 ISA、虚拟机字节码,或者某个未被官方支持的处理器时,最正统的做法不是硬改现有分析结果,而是定义一个新的 Architecture。这很适合某些大厂自定义VMP的解释器架构去给他做一套对应的架构
对于逆向工程来说,这一点特别重要:
在研究VMP的时候有几种方式可以做到“反编译”其指令集,第一种就是硬解析,就跟搓一个解释器一样,
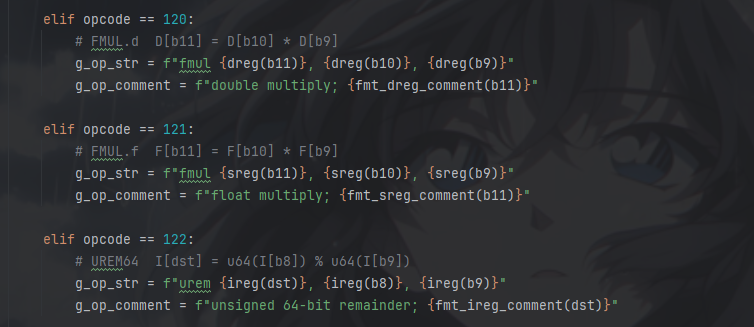
对指定的,我们已经分析好了的进行硬反编译,这样的效果当然不够灵活
还有一种就是llvmlite, 但llvmlite 只能帮你“造一个 IR 和执行/优化框架”,但不会像 Binary Ninja 自定义架构那样,天然给你接上反汇编、CFG、寄存器语义、LLIL/MLIL/HLIL 和反编译流程;做 VMP 时前者更像自建分析器,后者则是直接把虚拟 ISA 接进现成逆向平台。
2. 一个最小架构插件长什么样
官方示例和文档都表明,最小的 Python 架构插件通常包含:
- 一个继承自 Architecture 的类;
- 在这个类里填好架构元数据;
- 再实现几组关键接口:反汇编文本、控制流信息、LLIL lifting。
最小骨架通常类似这样:
from binaryninja import * |
这里最重要的不是语法,而是职责分工:
- get_instruction_text 负责“怎么看”;
- get_instruction_info 负责“怎么跳”;
- get_instruction_low_level_il 负责“这条指令到底做了什么”。
官方 Part 1 把前两个作为第一阶段重点,Part 2 再把 lifting 和 BNIL 作为第二阶段重点。
3. 架构元数据需要填什么
给出的 Architecture 示例里,最开始就要填一批基础属性,包括:
- name
- endianness
- address_size
- default_int_size
- instr_alignment
- max_instr_length
- regs
- stack_pointer(如果有)
这些属性看起来很“模板化”,但其实非常关键。因为 Binary Ninja 后续所有地址计算、寄存器宽度推断、栈语义、以及一部分 lifting 行为,都依赖这里的定义。比如某音的那个 24 字节定长 VM 指令集(,就应该把:
instr_alignment = 24
max_instr_length = 24
明确写出来,让 BN 从一开始就按这门 ISA 的规则去切指令。这个设计和官方架构教程是一致的:先把“架构世界观”讲清楚,再写具体指令。
4. get_instruction_text:反汇编
官方 Part 1 把“能看到正确的反汇编文本”作为第一个可验证里程碑。Binary Ninja 并不要求你一开始就把 LLIL 写满;你完全可以先把字节解码成指令文本,再慢慢补后面的分析。
这个接口的职责很单纯:
给输入字节和地址,返回:
- 一组 InstructionTextToken
- 当前指令长度
也就是说,这一层只关心 “这条指令长什么样”。
例如可以先打印成:
add r29, r29, #-784
此时它的价值主要体现在两个方面:
- 你终于可以用 Binary Ninja 的界面浏览虚拟机指令流,而不是只看 hexdump;
- 你可以验证自己的解码器是否稳定。
5. get_instruction_info:CFG
如果说 get_instruction_text 解决的是“显示问题”,那 get_instruction_info 解决的就是“控制流问题”。
Binary Ninja 需要知道一条指令是不是:
- 普通顺序执行;
- 无条件跳转;
- 条件跳转;
- 调用;
- 返回;
- 间接跳转。
因此这个接口通常要返回一个 InstructionInfo,并填入:
- length
- add_branch(BranchType.TrueBranch, target)
- add_branch(BranchType.FalseBranch, fallthrough)
- add_branch(BranchType.UnconditionalBranch, target)
- add_branch(BranchType.CallDestination, target)
等信息。官方教程里也是先做出 get_instruction_info,这样控制流图才会正确。
对于 VM 来说,这一步尤其重要。因为很多 VM 的 native dispatcher 是一坨间接跳转和跳表,但你真正想让 Binary Ninja 看到的,其实是“虚拟指令层面的 CFG”。这时你就需要在插件里把 VM 的分支语义直接告诉 BN,而不是把 native handler 的 br x12 原样照搬进去。
6. get_instruction_low_level_il
官方 Part 2 的重点就是这件事:
没有 LLIL,你只有“看起来像个反汇编器”;
有了 LLIL,你才真正进入 Binary Ninja 的分析流水线
因为 BNIL 的定义本身就是:
把具体架构的机器语义,翻译成架构无关的中间表示。
LLIL 处在这条链路的较低层,仍然接近汇编语言,但已经足够让 Binary Ninja 做控制流和数据流分析。官方概览文档明确指出,BNIL 是一组不同抽象层次的 IL 家族,其中 LLIL 是最接近原始指令语义、同时又能支撑更高层分析的关键层。
注:在分析VMP的handle的时候,我们盯着Low level IL其实我觉得远比直接看汇编好,因为IL我认为是比较解决硬还原VMP handle的解析地步的
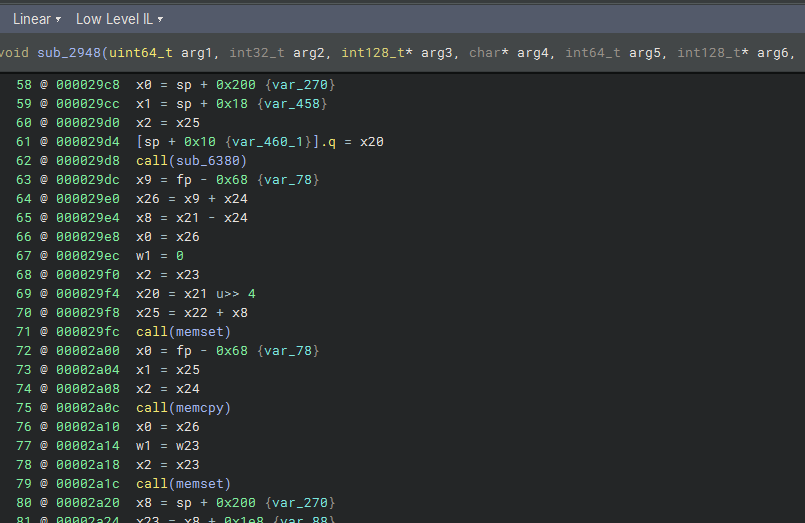
LLIL 的目标不是“把原指令机械翻译成另一种语法”,而是把指令的语义动作表达出来。
举例来说,一条加法指令在 LLIL 里关心的不是原始 opcode 编码,而是:
- 从哪个寄存器读;
- 做了什么算术;
- 结果写到哪里;
- 是否影响控制流。
因此你在架构插件里写 LLIL 的时候,本质上是在告诉 Binary Ninja:
这条指令,不是长得像什么,
而是“实际干了什么”。
因为 Binary Ninja 的很多高级能力都不是直接从反汇编文本长出来的,而是从 IL 长出来的。 |
LLIL
Binary Ninja 官方 LLIL 文档里一个非常重要的思路是:
LLIL 是树状表达(tree-based),它不是简单的字符串拼接,也不是纯文本伪代码。你通过 il.add、il.sub、il.set_reg、il.load、il.store、il.if_expr、il.jump 这些 API,去构建一棵表达“语义动作”的树。
例如一个很普通的整数加法:
src1 = il.reg(8, "r1") |
它的重点不是“对应哪条汇编”,而是这三件事已经完整表达了语义:
- 读 r1
- 读 r2
- 相加并写回 r3
这种表达方式一旦建立起来,BN 后面的分析管线就能接力工作。
ADD
当前 VM 的指令格式是固定 24 字节:
- bytes[0:8]:opcode
- bytes[8]:b8
- bytes[9]:b9
- bytes[10:12]:imm16
而 0x85 的语义已经通过静态分析和 trace 确认是:
ADD64.imm R[b9] = R[b8] + sext16(imm16)
也就是说,这是一条:
- 从 b8 指向的整型寄存器读值;
- 取一个有符号 16 位立即数;
- 相加;
- 写回 b9 指向的整型寄存器。
1. get_instruction_text
文本反汇编阶段,就跟硬还原一个道理,只需要把字段拼出来:
def get_instruction_text(self, data, addr): |
这一步只是为了显示
它还没有告诉 BN 这条指令怎么参与分析。
3. LLIL
真正关键的是 lifting:
def get_instruction_low_level_il(self, data, addr, il): |
不过这里有一个实践上更好的版本:
如果你想明确表达“有符号立即数”,应该先做 Python 侧的符号扩展,再喂给 il.const。因为 LLIL 里最重要的是把“值语义”表达准确,而不是保留原始字段格式。
例如更稳妥地写成:
def sx16(v): |
这段 LLIL 的本质是:
- 读寄存器;
- 做 64 位加法;
- 写结果。
这就是官方所说的“把架构语义 lifting 到 LLIL”。
条件跳转
反汇编
假设某个 VM opcode 的语义是:
if R[b8] == R[b9]: |
这类 case 在原生 handler 里通常会表现成:
- 取两个寄存器;
- 做比较;
- 条件成立时修改 VM 的 PC;
- 然后回到 dispatcher
但在 Binary Ninja 插件里,我们不应该把它“照着 native handler 抄写”;
而应该直接表达成 一条条件分支指令
这是自定义架构插件最核心的思想之一
get_instruction_info
这一步先告诉 BN,这是一条条件跳转:
def get_instruction_info(self, data, addr): |
这里的关键不是公式本身,而是:
Binary Ninja 的地址是按字节的,所以 VM 的“指令索引 PC”通常要映射回 byte offset。
这点在做固定长 VM 指令集时尤其重要。官方架构插件教程虽然大多以真实 CPU 为例,但它的接口约束天然要求地址和长度逻辑保持一致。
LLIL
LLIL 里,条件跳转最常见的写法是:
- 先构造比较表达式;
- 再用 if_expr;
- 然后给 true/false 两条边分别标标签。
这是官方 LLIL 与架构插件教程里最典型的控制流 lifting 模式。
例如:
from binaryninja import LowLevelILLabel |
这段代码的意义很直接:
- compare_equal 表达“两个寄存器是否相等”;
- if_expr 建立条件分支;
- true 边跳到目标;
- false 边顺流执行下一条。
1.表驱动opcode
上面的脚本是解码器的原型。插件比它多做的只有一件事: 每条指令除了”叫什么”,还要告诉 BN”干了什么”,BN 自己把寄存器变成变量、把内存变成结构体字段, 最后吐出 output_buf = args->output_buf 这种人话。
另外把 opcode 对照表做成配置文件而不是写死在代码里——因为在libmetasec_ml的so里面也有这么一套VMP,但是里面的opcode对应的指令和我们这个so不一样!当时逆完这个打开libmetasec_ml的vmp是十分心累的。。。。
2.调原生函数
我们的VMP的函数入参是放在栈上的,所以这个调用约定的函数入参需要栈上去找,这点所以我让AI还原成了结构体的形式
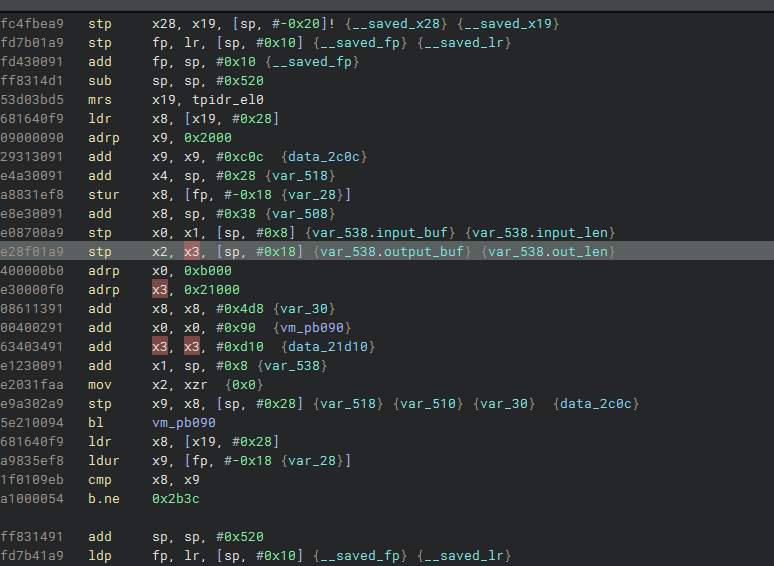
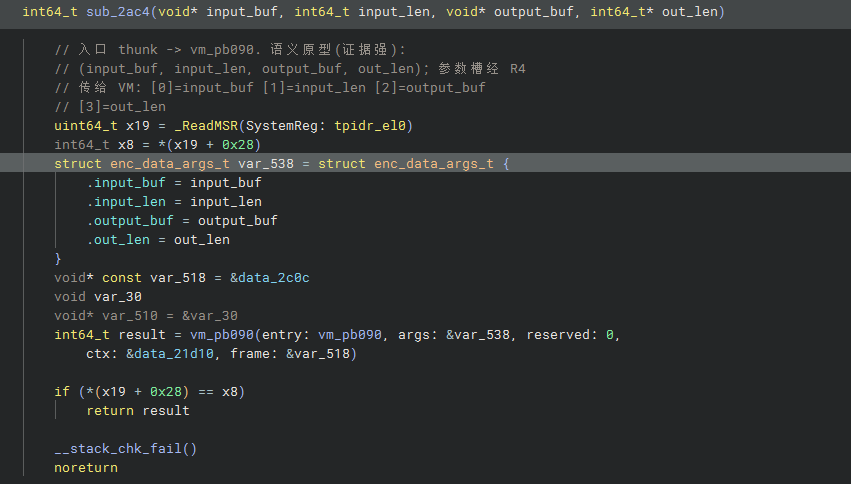
3.符号执行器,将调用的原生函数计算
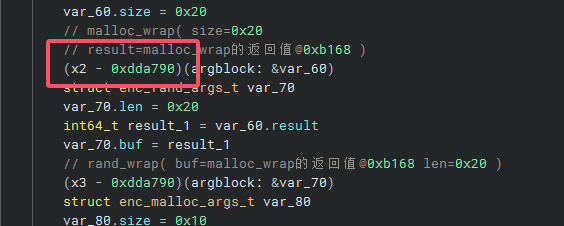
可以看到,这个vmp的调用原生函数是通过查表的方式,类似与间接调用的形式进行的,所以这里是写了一个符号执行器去进行的计算函数的真实值
4. 效果
Low Level IL
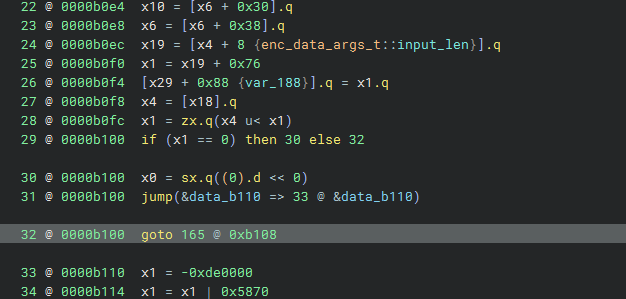
控制流修复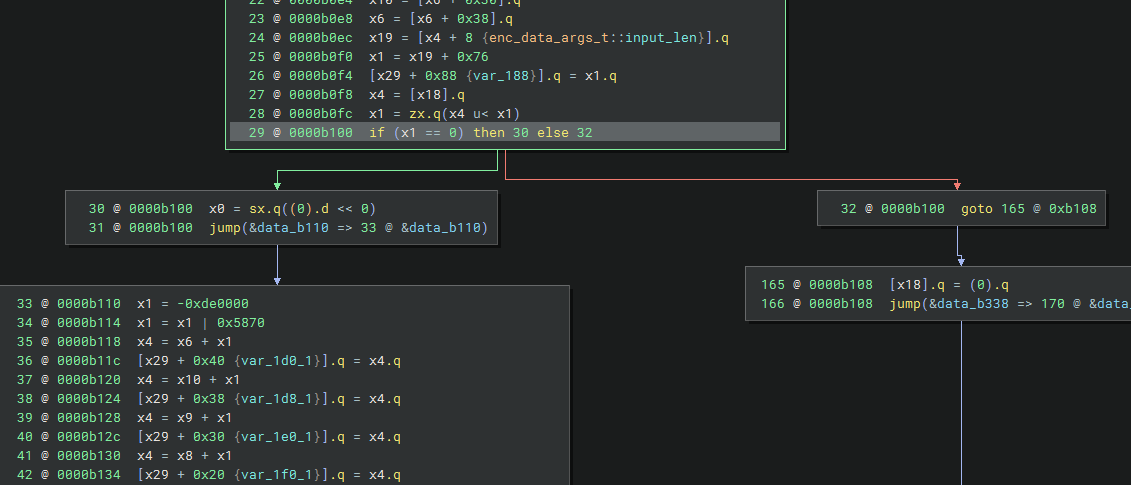
High Level IL
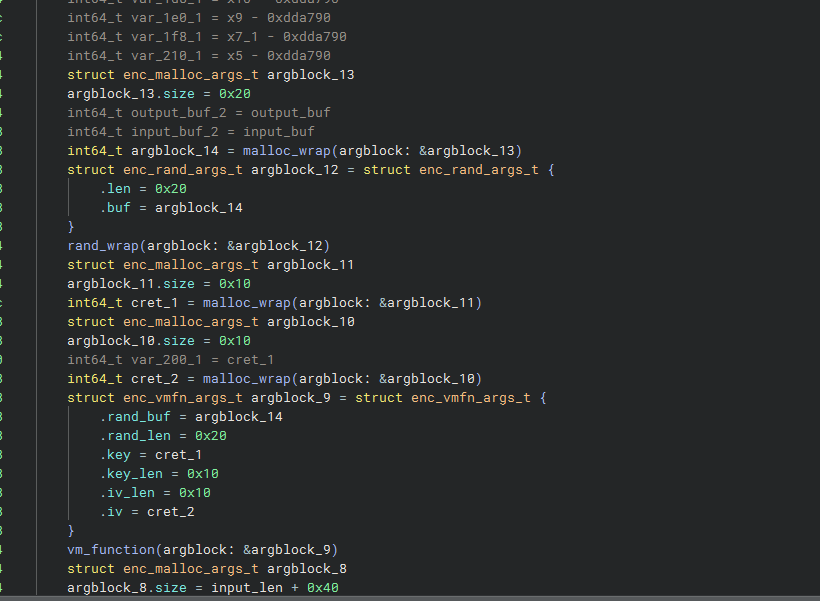
这是插件反编译的效果,可以看出效果是非常好的
参考资料
- https://binary.ninja/2020/01/08/guide-to-architecture-plugins-part1.html
- https://binary.ninja/2021/12/09/guide-to-architecture-plugins-part2.html
- https://binary.ninja/2026/02/20/quark-platform-part-1.html
- https://docs.binary.ninja/dev/bnil-overview.html
- https://docs.binary.ninja/dev/bnil-llil.html
- https://docs.binary.ninja/dev/bnil-modifying.html
- https://docs.binary.ninja/guide/plugins.html